Was ist passiert?
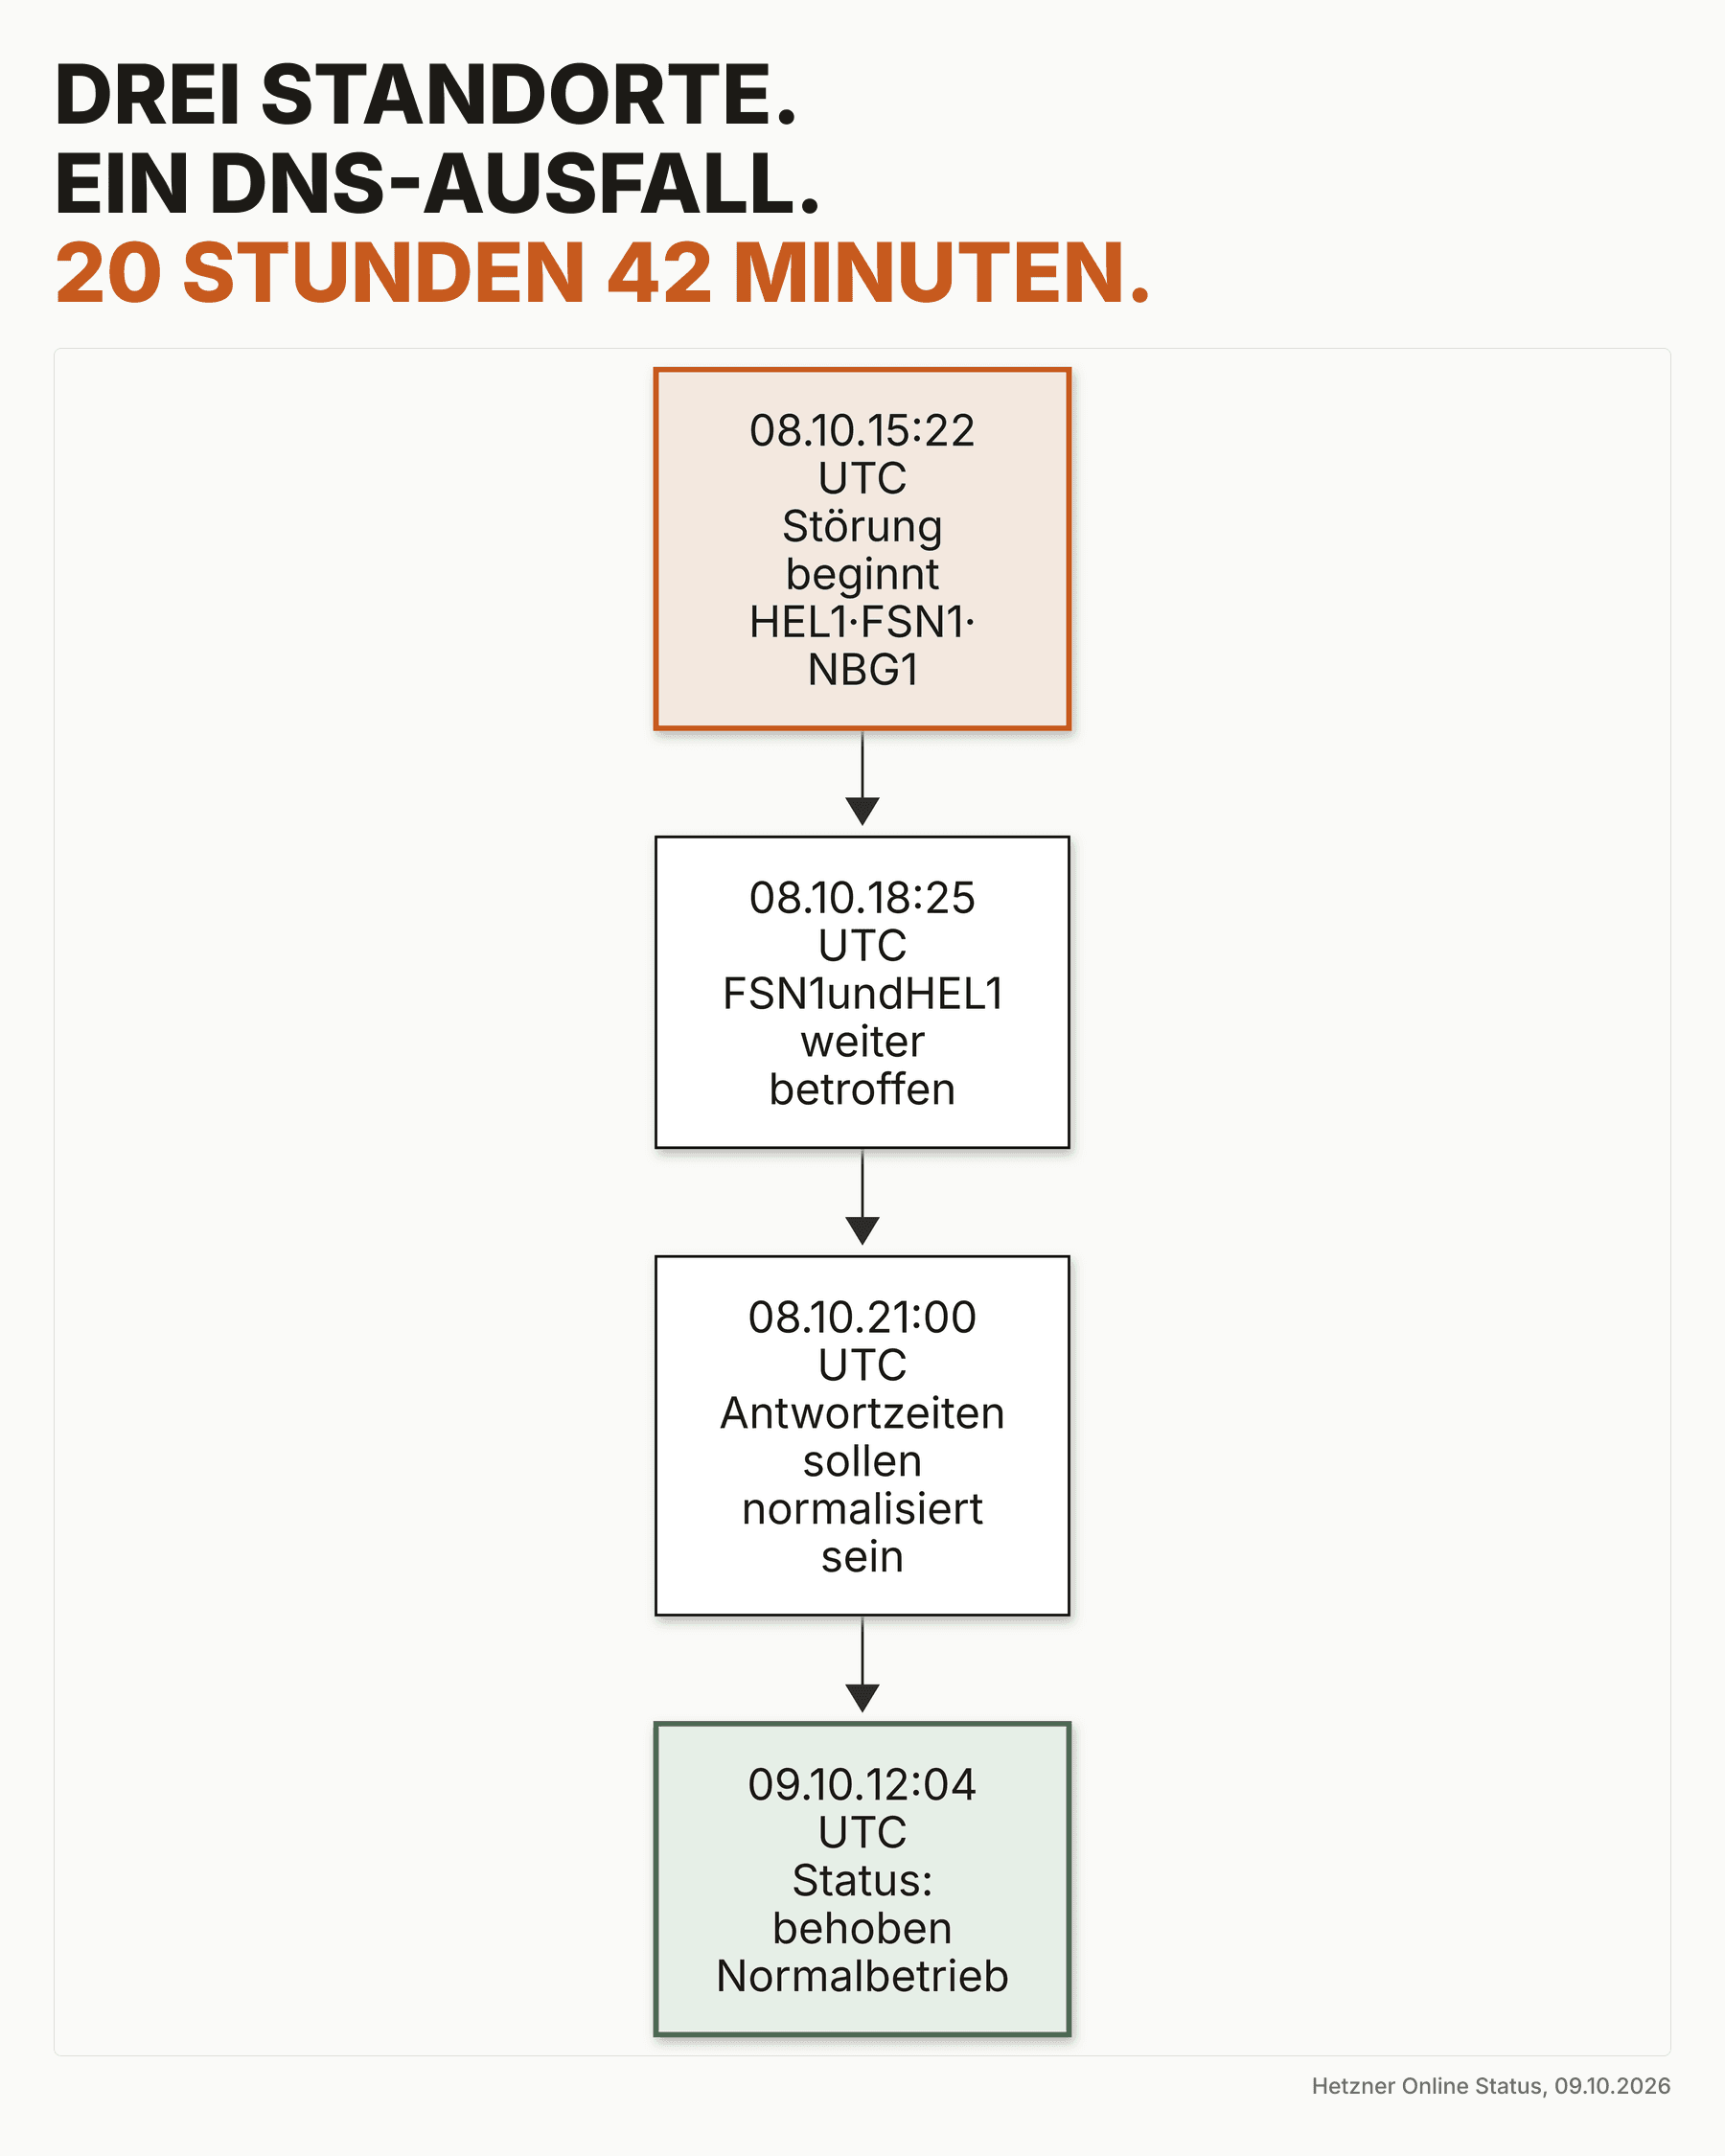
Hetzner meldete am 8. Oktober 2026 um 15:22 UTC eine Störung seiner rekursiven DNS-Dienste an den Standorten HEL1, FSN1 und NBG1. Der Anbieter setzte den Vorfall am 9. Oktober um 12:04 UTC auf behoben. Damit dauerte die Störung 20 Stunden und 42 Minuten.
Rekursive DNS-Server ermitteln für angefragte Domains die IP-Adresse bei den zuständigen autoritativen Nameservern. Fällt dieser Zwischenschritt aus oder antwortet langsam, können Websites, APIs und externe Dienste unerreichbar wirken, obwohl Webserver und autoritative DNS-Zone selbst funktionieren. Die offizielle Statusmeldung nennt keine technische Ursache. Betreiber sollten daher nicht über einen Auslöser spekulieren, sondern die sichtbare Abhängigkeit prüfen.
Quelle und Zeitangaben stammen aus der Hetzner Statusmeldung vom 9. Oktober 2026.
Zeitverlauf des Ausfalls
Um 18:25 UTC meldete Hetzner, dass das Problem in FSN1 und HEL1 weiterhin bestand. Um 21:00 UTC sollten sich die Antwortzeiten normalisiert haben, während der Anbieter die Lage weiter beobachtete. Erst am folgenden Tag um 12:04 UTC wurde der Status auf behoben gesetzt.
Dieser Verlauf zeigt einen wichtigen Unterschied im Störungsmanagement: Eine erste Normalisierung ist noch keine bestätigte Behebung. Für die eigene Kommunikation zählt deshalb nicht nur, ob einzelne Abfragen wieder funktionieren. Entscheidend ist, ob Monitoring und Anbieterstatus über einen angemessenen Zeitraum stabil bleiben.
Wer war betroffen?
Direkt betroffen waren laut Statusmeldung die rekursiven DNS-Systeme in HEL1, FSN1 und NBG1. Relevant war der Vorfall für Server und Dienste, die diese Hetzner Resolver tatsächlich zur Namensauflösung nutzten. Hetzner dokumentiert dafür die IPv4-Adressen 185.12.64.1 und 185.12.64.2 sowie zwei IPv6-Adressen. Die Resolver funktionieren laut Dokumentation nur für Cloud Server und Dedicated Server in Hetzner Rechenzentren.
Nicht jede bei Hetzner gehostete Website war deshalb automatisch ausgefallen. Eine Website kann ihre autoritativen Nameserver bei einem anderen Anbieter haben und intern trotzdem einen Hetzner Resolver verwenden. Umgekehrt kann ein Server einen anderen rekursiven Resolver nutzen. Die konkrete Resolver-Konfiguration entscheidet.
Die Funktionsweise und Adressen beschreibt Hetzner in der Dokumentation zu rekursiven Nameservern, Stand 11. Mai 2026.
So prüfen Sie die Abhängigkeit in zwei Minuten
Prüfen Sie zuerst, ob der Server die dokumentierten Hetzner Resolver verwendet. Unter Linux liefern resolvectl status oder ein Blick in die tatsächlich verwaltete Resolver-Konfiguration die aktiven DNS-Server. Ändern Sie dabei noch nichts. Führen Sie anschließend auf einem Hetzner Server eine gezielte Abfrage gegen beide dokumentierten IPv4-Adressen aus.
Vergleichen Sie das Ergebnis mit einer normalen Abfrage über den aktuell konfigurierten Systemresolver. Antworten beide gezielten Abfragen nicht, während ein unabhängiger Resolver funktioniert, ist die Abhängigkeit eingegrenzt. Halten Sie Uhrzeit, Standort, Antwortzeit und Fehlermeldung fest und gleichen Sie den Befund mit der offiziellen Statusseite ab.
resolvectl status
dig @185.12.64.1 ihre-domain.de +time=2 +tries=1
dig @185.12.64.2 ihre-domain.de +time=2 +tries=1
dig ihre-domain.de +time=2 +tries=1
Ein ähnliches Vorgehen hilft bei schwer einzuordnenden Fehlern. Unsere Checkliste zur WordPress REST API trennt ebenfalls Erreichbarkeit, Anwendung und Berechtigung.
Was jetzt zu tun ist
Nach der Entstörung sollten Betreiber zuerst die normale Resolver-Konfiguration und alle betroffenen Dienste prüfen. Wiederholen Sie DNS-Abfragen, testen Sie Website, API, Mailversand und externe Schnittstellen und kontrollieren Sie die Logs für den Zeitraum des Ausfalls. Fehlgeschlagene Jobs sollten nur dann erneut gestartet werden, wenn doppelte Verarbeitung ausgeschlossen ist.
Für künftige Vorfälle gehört ein alternativer Resolver in einen dokumentierten Notfallplan. Ein Wechsel während einer Störung sollte nur erfolgen, wenn Netzwerkregeln, Datenschutzanforderungen und Rückweg bekannt sind. Sichern Sie den vorherigen Zustand, ändern Sie kontrolliert und prüfen Sie danach Auflösung und Anwendung. Ein ungetesteter Fallback kann eine DNS-Störung durch neue Fehler ersetzen.
- Resolver und abhängige Dienste inventarisieren.
- Statusseite und eigenes Monitoring getrennt beobachten.
- Fallback mit Verantwortlichem und Rückweg dokumentieren.
- Abfragen von einem externen Standort in das Monitoring aufnehmen.
- Kommunikation erst nach stabiler Prüfung abschließen.
Wer Serverantworten und Seitengeschwindigkeit gemeinsam prüfen möchte, findet im Beitrag WordPress PageSpeed optimieren eine systematische Messreihenfolge.
Was Betreiber daraus lernen können
Ein externer Websitecheck reicht nicht aus, wenn nur HTTP gemessen wird. Sinnvoll sind getrennte Prüfungen für DNS-Auflösung, TLS und HTTP, jeweils von mindestens einem unabhängigen Standort. So wird sichtbar, ob die Ursache vor dem Webserver liegt. Zusätzlich sollte die Anbieterstatusseite als Informationsquelle hinterlegt sein, aber nicht als einziges Signal dienen.
Redundanz ist nur wirksam, wenn sie unabhängig und getestet ist. Zwei Resolver-Adressen desselben Dienstes können dieselbe Störung teilen. Ein Fallback sollte deshalb nicht nur auf dem Papier existieren. Regelmäßige Wartungsfenster eignen sich, um Umschaltung, Rückkehr und Alarmierung ohne Zeitdruck zu prüfen.
Updates, Backups und technische Kontrollen bündeln wir für WordPress Seiten in unserer WordPress Wartung. Dort lässt sich auch klären, welches Monitoring zur tatsächlichen Infrastruktur passt.
Weitere nüchterne Einordnungen zu Betrieb und Sicherheit finden Sie im devvibe Magazin.
Fazit
Der Hetzner Vorfall war kein allgemeiner Beleg für einen Ausfall aller dort gehosteten Websites. Er war eine lange Störung eines konkreten Infrastrukturbausteins an drei Standorten. Wer Resolver, Monitoring und Fallbacks sauber dokumentiert, kann einen ähnlichen Vorfall schneller erkennen und ruhiger behandeln.