Was ist passiert?
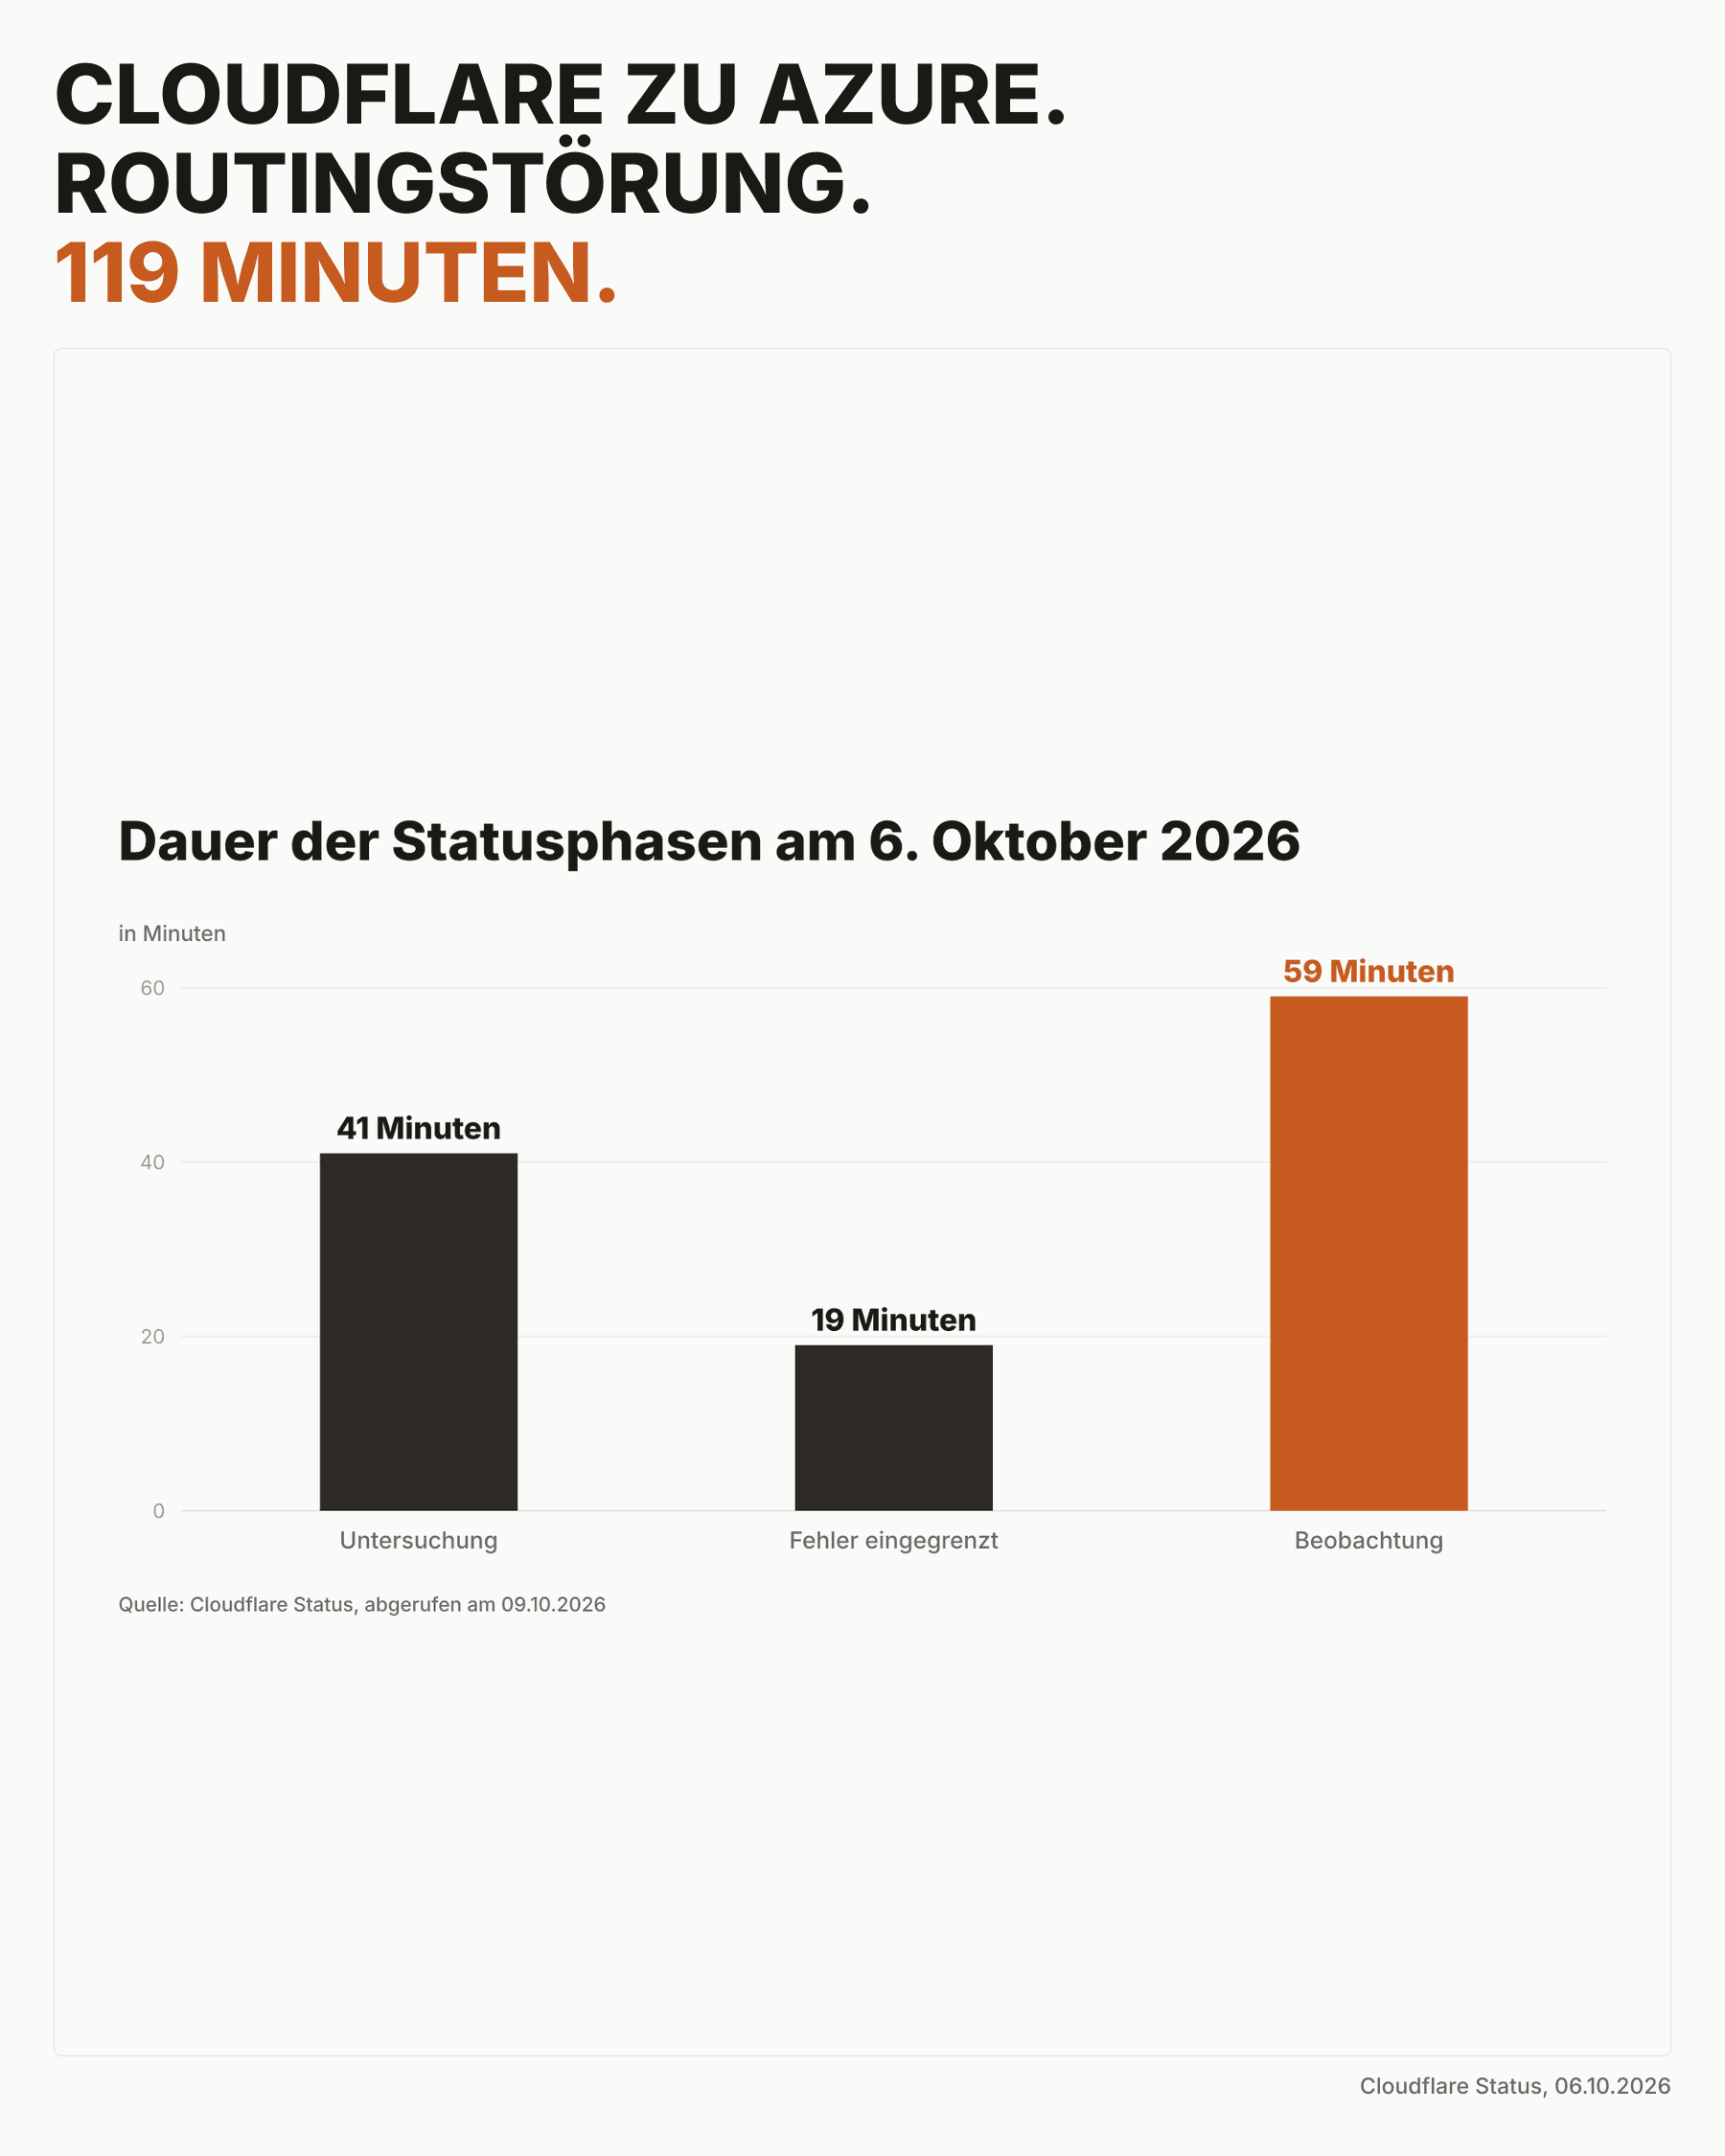
Cloudflare meldete am 6. Oktober 2026 um 13:34 Uhr UTC ein Problem beim Netzwerk Routing zu Microsoft Azure. Anfragen, die von Cloudflare an Ursprungssysteme bei Azure weitergeleitet wurden, konnten Fehler liefern. Um 14:15 Uhr war das Problem laut Statusseite eingegrenzt, ab 14:34 Uhr beobachtete Cloudflare die Lage und um 15:33 Uhr wurde der Vorfall als behoben markiert. Vom ersten Hinweis bis zur Entwarnung vergingen damit rund 119 Minuten.
Cloudflare stufte den Einfluss auf der Statusseite als gering ein und nannte den Bereich Network als betroffen. Eine konkrete technische Ursache veröffentlichte der Anbieter dort nicht. Deshalb lässt sich belastbar nur sagen, dass der Routingweg zu Azure-Ursprüngen gestört war. Aussagen über eine Fehlkonfiguration, einen Angriff oder einen Ausfall von Azure wären ohne weitere Primärquelle Spekulation.
Der vollständige Zeitverlauf steht auf der Cloudflare Statusseite zum Vorfall vom 6. Oktober 2026.
Wer war betroffen?
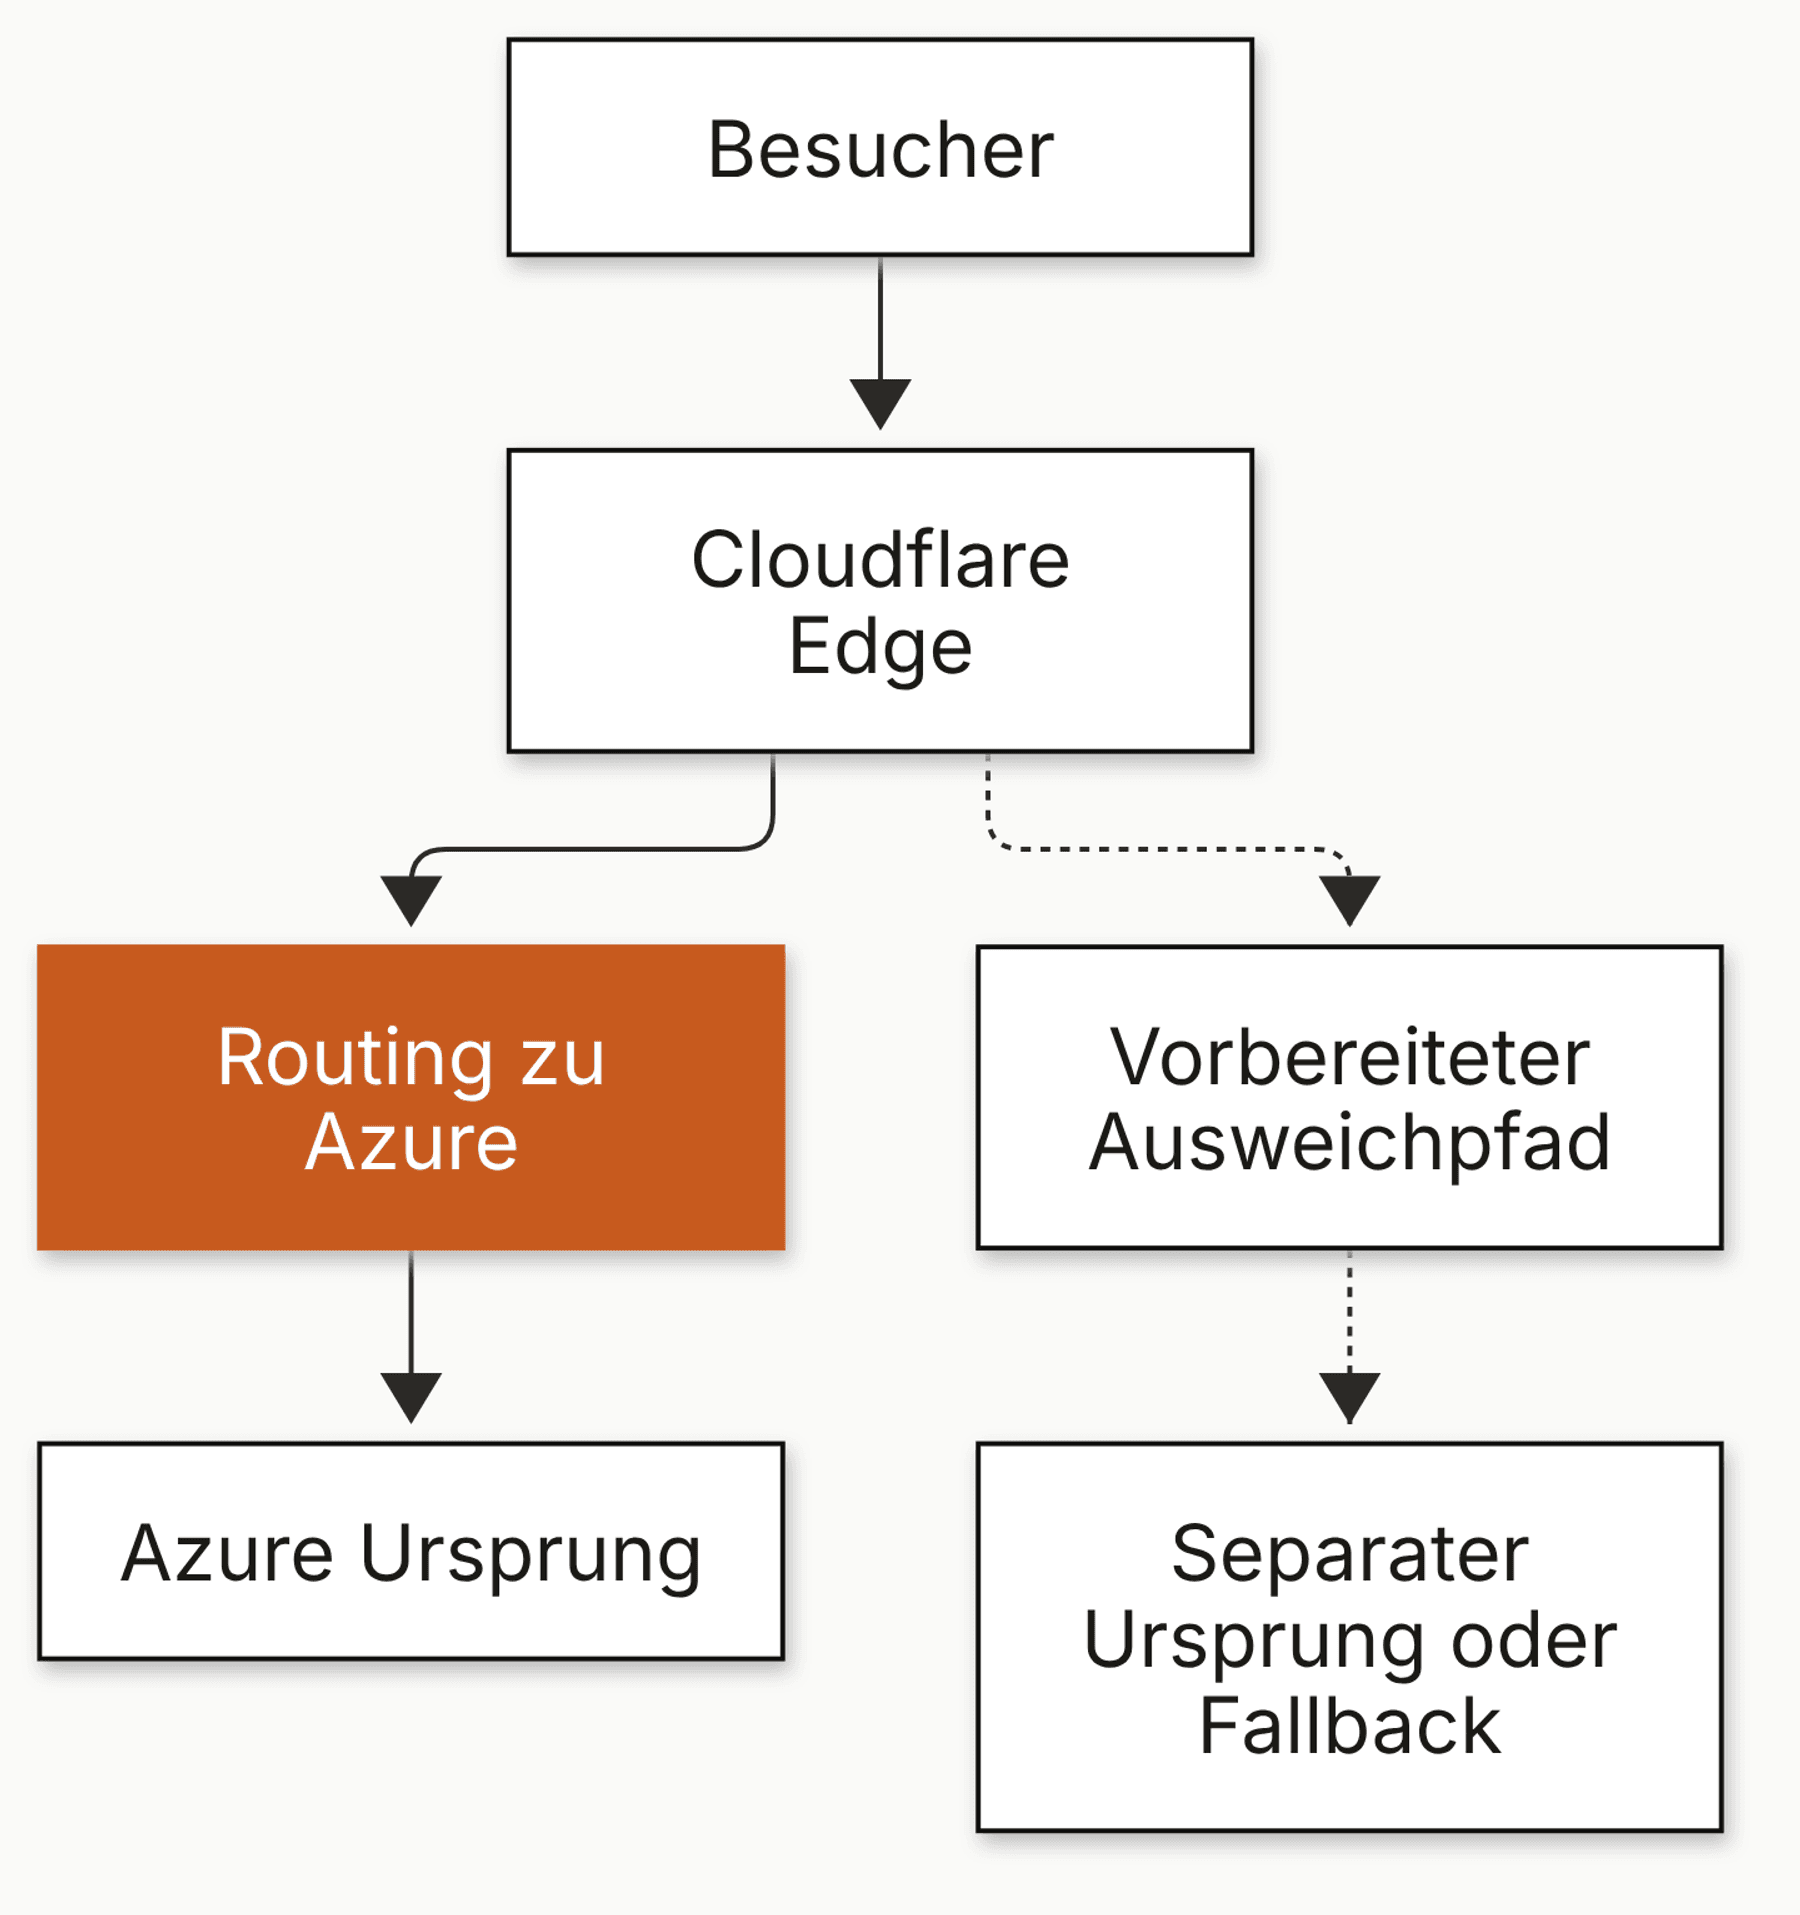
Relevant war der Vorfall für Websites und Anwendungen, deren öffentliche Anfragen zunächst Cloudflare erreichten und anschließend zu einem Ursprung bei Microsoft Azure weiterliefen. Sichtbar werden konnten etwa Fehlerseiten, fehlgeschlagene API-Aufrufe oder nicht erreichbare dynamische Inhalte. Die Statusmeldung belegt jedoch weder einen flächendeckenden Cloudflare-Ausfall noch einen allgemeinen Azure Ausfall.
Betreiber mit Ursprüngen bei anderen Anbietern waren nach der veröffentlichten Beschreibung nicht das Ziel dieses konkreten Vorfalls. Auch bei Azure hängt der tatsächliche Einfluss von Zone, Routing, Cache und Anwendung ab. Vollständig im Cloudflare Cache liegende Inhalte können weiter erreichbar gewesen sein, während dynamische Seiten oder Formulare Fehler lieferten. Entscheidend sind deshalb die eigenen Messdaten.
So prüfen Sie den Vorfall in zwei Minuten
Öffnen Sie zuerst Ihr externes Verfügbarkeitsmonitoring und begrenzen Sie den Zeitraum auf 6. Oktober 2026, 13:34 bis 15:33 Uhr UTC. Suchen Sie nach erhöhten HTTP-Fehlern, Zeitüberschreitungen und fehlgeschlagenen Transaktionen. Prüfen Sie danach die Protokolle des Azure-Ursprungssystems. Wenn der Ursprung gesund war, Anfragen über Cloudflare aber fehlschlugen, passt das zum veröffentlichten Verlauf.
Kontrollieren Sie zusätzlich wichtige Funktionen wie Anmeldung, Suche, Warenkorb, Formulare und API-Aufrufe. Ein grüner Startseitencheck reicht nicht, wenn statische Inhalte aus dem Cache kommen. Fehlen eigene Messwerte, dokumentieren Sie diese Lücke. Die Statusseite erklärt einen möglichen Zusammenhang, ersetzt aber keinen Nachweis für die eigene Anwendung.
- Monitoring auf das veröffentlichte Zeitfenster stellen.
- Edge Fehler und Protokolle des Azure-Ursprungs vergleichen.
- Mindestens eine dynamische Kernfunktion prüfen.
- Befund und fehlende Messpunkte im Betriebsprotokoll notieren.
Bei langsamen statt fehlerhaften Seiten hilft die getrennte Prüfung aus unserem Beitrag WordPress PageSpeed systematisch optimieren.
Was ist jetzt zu tun?
Für diesen Vorfall gibt es keine Softwareversion und kein Update, das Seitenbetreiber installieren müssen. Cloudflare hat den Vorfall als behoben markiert. Prüfen Sie dennoch, ob Warteschlangen abgearbeitet wurden, Formulare wieder zustellen und Caches keine Fehlerseite festhalten. Bei geschäftskritischen Vorgängen sollten fehlgeschlagene Aktionen aus dem Zeitfenster gezielt nachverfolgt werden.
Als Übergangsmaßnahme lohnt sich ein externer Check, der nicht nur die Startseite, sondern eine dynamische Funktion testet. Abonnieren Sie außerdem die Statusmeldungen Ihrer Infrastruktur-Anbieter. Ändern Sie DNS oder Proxy Einstellungen nicht spontan im Störungsfall. Ein ungeplanter Bypass kann Schutzfunktionen umgehen und bringt wenig, wenn der alternative Weg nicht vorher getestet wurde.
Für APIs und dynamische Funktionen zeigt unser Leitfaden zur WordPress REST API typische Prüfstellen.
Was Betreiber daraus lernen können
Eine Website kann an Edge, Netzwerkweg oder Ursprung scheitern. Monitoring sollte diese Ebenen deshalb getrennt beobachten. Cloudflare beschreibt für sein Load Balancing regelmäßige Monitor Anfragen an Endpunkte. Wird ein Pool als ungesund erkannt, kann der Load Balancer ihn aus der Rotation nehmen. Das hilft nur, wenn ein zweiter gesunder Pool vorhanden ist und der Monitor eine echte Kernfunktion prüft.
Ein belastbarer Fallback braucht einen unabhängigen Ursprung, aktuelle Daten und einen regelmäßig getesteten Umschaltweg. Zwei Namen für denselben Azure-Ursprung schaffen keine Redundanz. Ebenso wichtig sind eine öffentlich dokumentierte Statusseite, klare Verantwortlichkeiten und ein kurzer Ablauf für Kommunikation und Nachprüfung. Nicht jede Website benötigt eine komplexe Mehranbieter-Architektur. Je höher der Schaden einer Stunde Ausfall, desto eher lohnt sich die Vorbereitung.
Cloudflare erklärt Funktionsweise und Grenzen in der Dokumentation zu Load-Balancing-Monitoren.
Für individuell betriebene Anwendungen verbindet unsere Software-MVP-Entwicklung Entwicklung, Tests und einen kontrollierten Betrieb.
Ruhig prüfen, dann gezielt vorsorgen
Der Vorfall ist beendet. Für Betreiber geht es jetzt nicht um hektische Änderungen, sondern um eine saubere Auswertung: War die eigene Website betroffen, haben die Messungen den Fehler gezeigt und waren wichtige Funktionen nach der Entwarnung wieder intakt? Aus diesen Antworten ergibt sich, ob ein zusätzlicher Check, ein Status-Abonnement oder ein echter Fallback sinnvoll ist.
Bei betreuten WordPress Websites gehören Updates, Backups und laufende technische Kontrollen in einen festen Prozess. Infrastruktur Abhängigkeiten sollten dabei sichtbar dokumentiert sein, auch wenn sie außerhalb von WordPress liegen.
Mehr zu unserem laufenden Betrieb finden Sie bei der WordPress Wartung.